
图 A · Original
分辨率越高,光栅化缓存越大。
看不断增厚的橙色区域:原始训练逻辑把全图光栅化缓存保留到反向计算。像素和高斯交叠越多,临时工作集就越大,到了 12K 便显存不足。
浙江大学
实验条件:同一模型,只提高图像分辨率。 从同一个 Bicycle 模型(约 599 万个高斯)出发,保持视角与视野不变,将图像宽度从 1K 增至 16K,对比训练计算的临时工作集、时间和 L1 损失。

图 A · Original
看不断增厚的橙色区域:原始训练逻辑把全图光栅化缓存保留到反向计算。像素和高斯交叠越多,临时工作集就越大,到了 12K 便显存不足。

图 B · BoundedGS
从 1K 到 16K,曲线始终贴近 1.07 GiB。局部区域算完就释放,更多像素不再要求所有光栅化缓存同时驻留。
这里没有橙色,是因为峰值出现在光栅化结束后的投影反向阶段,此时光栅化缓存已释放。到图 3 看缓存如何退出 ↘

图 C · 时间与计算一致性
蓝色时间曲线低于灰色:11K 时从 21.76 降至 19.79 秒。紫色差异曲线贴近零,两者 L1 损失的最大相对差异约 6.77 × 10⁻⁷。
01 / 问题与洞见
提高图像分辨率,会增加像素和高斯与图像小块的交叠。它们产生的光栅化缓存与投影、梯度状态同时驻留,构成训练中的显存峰值。

左右滑动查看完整图表 ↔
同一视图内,高斯参数保持不变。一个局部区域完成光栅化、损失与反向计算后,其梯度贡献可以先归并,局部缓存随即释放,再处理下一区域。
同样大的区域,可能包含不同数量的高斯交叠。BoundedGS 根据交叠数量、像素及缓冲区布局估计负载,让密集区域更小,稀疏区域更大。
所有区域仍覆盖完整图像、使用同一相机与全局模型,汇总整个视图的梯度后,再进行一次参数更新。
02 / 方法
图 3 将这些改变放到同一条组件对照链上:A 是全图执行;B 分离两段反向;C 加入有界局部光栅化;D、E 继续压缩候选投影和梯度;F 展示进一步调整预算的取舍。


A:光栅化和反向状态在峰值附近同时驻留。
横轴为分配事件从 0% 到 100% 的顺序;纵轴为工作集(GiB)。A–C 与 D–F 的纵轴范围不同。
A → B
先完成光栅化反向,收集投影属性的梯度,再进行投影反向。这样,已经完成工作的光栅化缓存可以在后续梯度状态增长前退出。
B → C
将图像划为 Leaf,逐块完成前向、损失和反向。超过预算的区域继续细分;相机布局可以缓存,但每次执行前重新检查当前负载。
C → D → E
局部缓存变小后,全模型投影和梯度成为新的主要开销。候选索引投影与紧凑梯度只为可能参与当前视图的高斯保留详细状态。
更细的分组和更小的 Leaf 预算(F)可以进一步降低工作集,也会增加执行开销。渲染之外,CPU 辅助结构重建与有界图像供给继续控制训练过程中的资源需求。
384 MiB 是局部光栅化负载预算,不是整个训练进程的显存上限。局部 SSIM 窗口与全图 SSIM 的边界处理有差异,最终质量在完整图像上评测。
03 / 效果
在 RTX 4090 上,13 个原生高分辨率场景均训练 30,000 步。Original 是同一训练框架中的全图执行对照;两者采用相同的初始化方式和高斯数量调度。
9.97 → 1.76 GiB五个 5K 室外场景的渲染工作集均值
36.7 → 33.9 分钟相同场景组的完整训练平均时间
24.44 → 24.42 dB相同场景组的平均 PSNR
| 数据组 / 原生分辨率 | 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 时间 ↓分钟 | 工作集 ↓GiB |
|---|---|---|---|---|---|---|
| Mip-NeRF 360 室外5 个场景 · 5K | Original | 24.44 | 0.739 | 0.314 | 36.7 | 9.97 |
| BoundedGS | 24.42 | 0.739 | 0.314 | 33.9 | 1.76 | |
| Mip-NeRF 360 室内4 个场景 · 3K | Original | 31.52 | 0.932 | 0.239 | 16.5 | 4.43 |
| BoundedGS | 31.64 | 0.932 | 0.239 | 15.9 | 0.87 | |
| Tanks and Temples4 个场景 · 4K | Original | 22.92 | 0.764 | 0.294 | 23.2 | 7.65 |
| BoundedGS | 22.91 | 0.764 | 0.294 | 23.0 | 1.79 |
左右滑动查看完整表格 ↔
保留论文表 1 的数值、精度与工作集加粗方式,各组对场景等权平均。工作集为逐场景渲染临时峰值的均值;训练计时排除评测、视频、PLY 保存与资源监控开销。↑ 越高越好,↓ 越低越好。
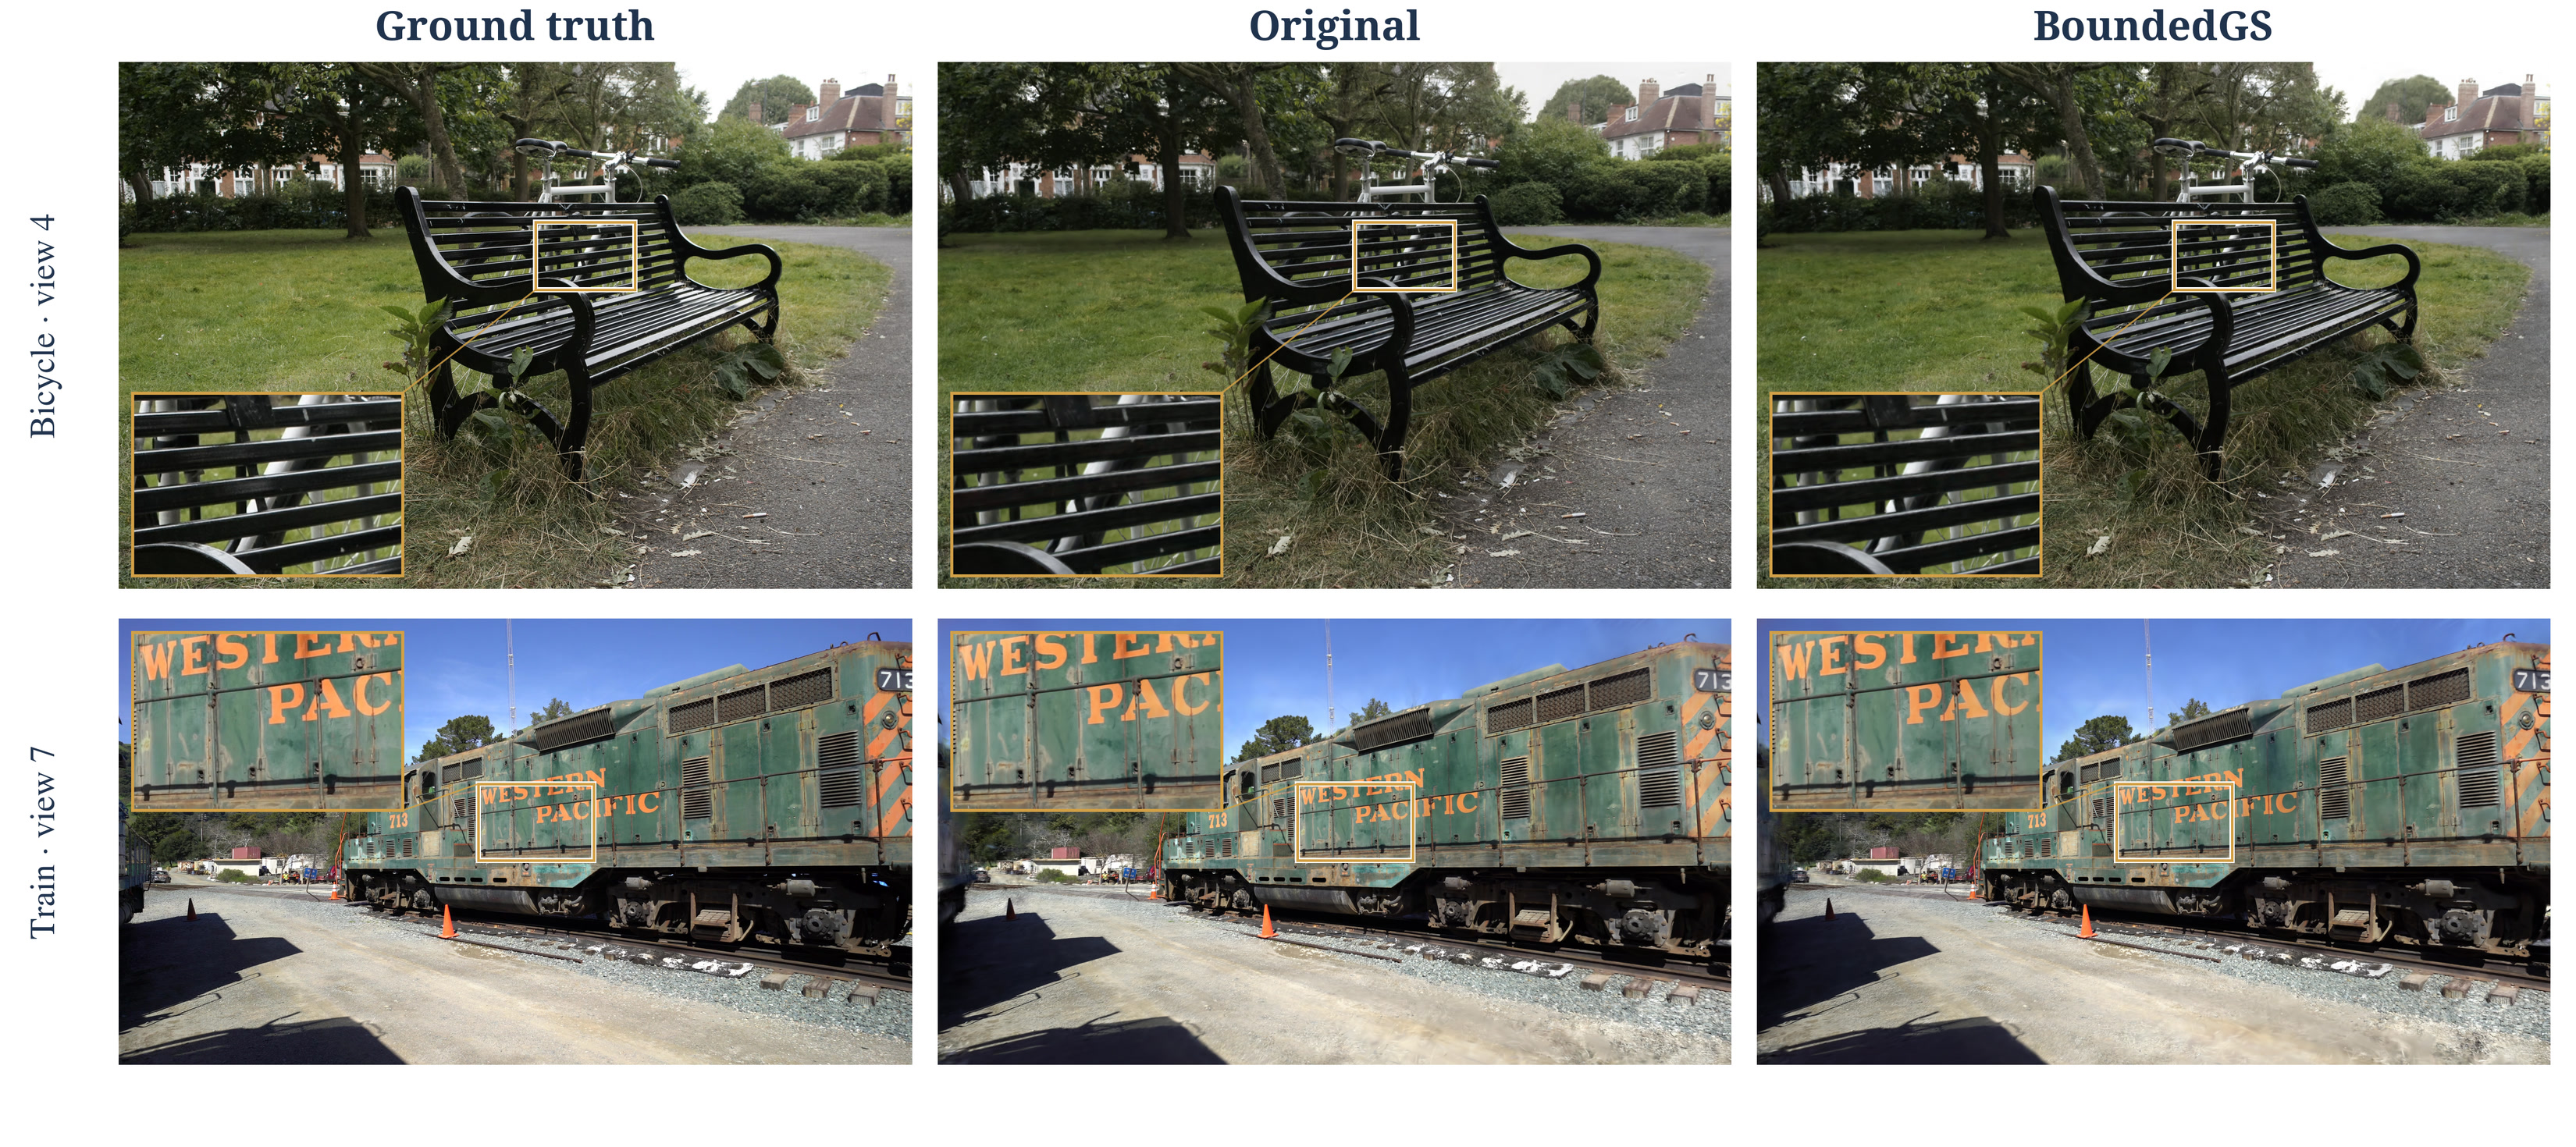
左右滑动对比三组图像 ↔
沿着图 3 的 A→E,依次释放光栅化缓存、控制局部负载、压缩投影和梯度,五场景平均工作集从 9.980 降到 1.662 GiB,计算也更快。继续缩小预算的 F 能再省显存,但开始付出时间代价。
| 配置 | 工作集 / GiB ↓ | 第二轮时间 / 秒 ↓ | 渲染相似性 SSIM ↑ |
|---|---|---|---|
| A · Original | 9.980 | 12.19 | 1.000000 |
| B · 分离反向 | 7.638 | 11.35 | 0.999991 |
| C · 有界局部光栅化 | 5.046 | 12.04 | 0.999991 |
| D · 候选索引投影 | 3.274 | 11.23 | 0.999990 |
| E · 紧凑梯度(BoundedGS) | 1.662 | 10.46 | 0.999991 |
| F · 3 × 3 分组 / 128 MiB | 1.305 | 12.69 | 0.999991 |
左右滑动查看完整表格 ↔
固定模型训练模拟,五场景第二轮均值。SSIM 比较与 Original 的渲染相似性,越接近 1 越相似。
分块也能省显存。关键在于:如何决定块的大小,以及为每一块重复做多少工作。 下面先让固定分块也使用紧凑投影和梯度,再比较分区策略与逐块更新的代价。
图 5 · 固定像素块 vs. 按负载划分
同一个约 599 万高斯的 Bicycle 模型,分辨率从 2K 增至 16K。三条路径都使用阶段分离、紧凑投影和梯度;A/B 将图像切成 2K 像素宽的固定块,C 按 384 MiB 负载预算划分。

左右滑动查看四个子图 ↔
B → C:同样每视图更新一次,按负载划分更合适。 固定面积的块仍可能包含很密集的高斯交叠。Auto Leaf 随负载调整区域大小,工作集保持约 1.07 GiB;16K 时,时间从固定分块的 49.3 秒降至 35.7 秒。
A → D:每块都更新,节省显存的代价很高。 16K 被切成 8 × 8 块,每视图要做 64 次参数更新,并重复筛选、投影和梯度构建;这一轮用时达到 149.4 秒。
图 5 的结论:局部负载决定缓存大小,完整视图汇总后更新避免逐块更新的重复开销。
图 6 · 固定网格继续细分的代价
换用约 1,198 万高斯的 Bicycle 模型,对比 1 × 1、2 × 2、4 × 4 固定网格,每块独立更新。上排重复全量投影;下排已经加入阶段分离、候选投影和紧凑梯度。

左右滑动查看六个子图 ↔
即使采用紧凑状态,重复工作仍然存在。 2 × 2 和 4 × 4 分别要做 4 次、16 次参数更新;下排时间从 21.84 秒升至 65.36 秒。
与同模型的 Auto Leaf 比,收益和代价一起看。 Auto Leaf 为 1.572 GiB、11.57 秒。紧凑 4 × 4 降到 0.848 GiB,多省 0.724 GiB 临时显存,耗时却达到约 5.65 倍。
图 6 的结论:更小的固定块可以换取更低峰值;Auto Leaf 的优势是以更少的重复计算取得更好的显存与时间折中。
同模型 Auto Leaf 数值来自论文附录 C.2。以上数字使用图中 Warm 的全视角峰值与时间;红色 Trace peak 标记的是单个视角。